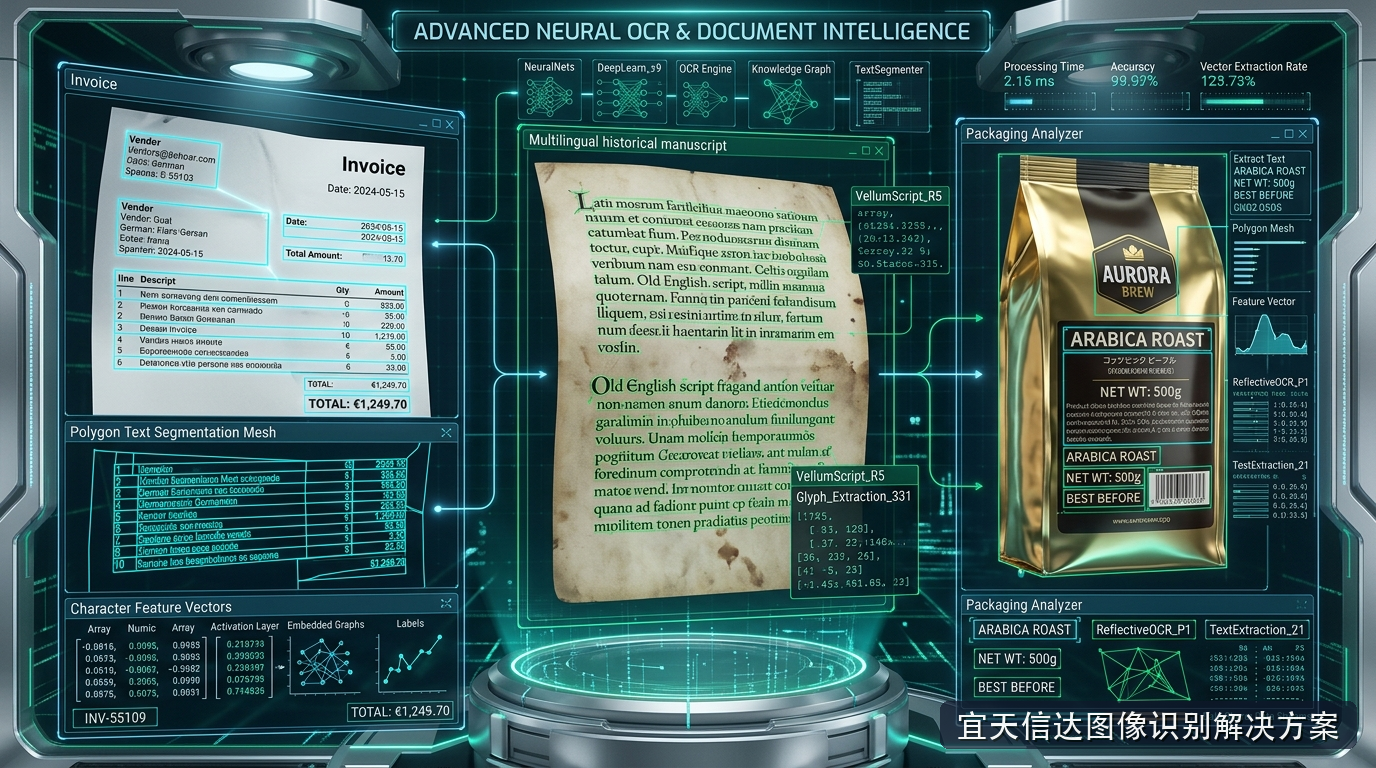
在政务机要归档、金融离线凭证审核、高端制造设备特种金属铭牌巡检以及医药化学品反光软包装检验等场景中,文档图像的文字内容提取始终面临着最为严酷的物理环境考验。在不受控的现场拍摄条件下,待识别文本极少以端正平直、高对比度的规整扫描件形式出现。相反,大角度俯仰视角引起的梯形透视失真、纸张揉皱形成的剧烈起伏阴影、反光塑料膜造成的白色强光亮斑,以及多语种字母纵横交错的复杂版面,构成了传统光学字符识别算法难以逾越的障碍。
更为严苛的是,受限于核心商业机密保密规范与涉密外事合规要求,此类关键业务数据严禁上传至公有云API接口进行解析。所有文字检测、版面几何矫正与高维字符特征解码,必须在一台功耗受限、完全切断外部网络的本地边缘主机或加固型手持巡检仪上独立闭环运行。这要求声像与字符处理模型在兼顾极限精度的同时,必须在底层算力架构上实现彻头彻尾的汇编级瘦身与加速,成为新一代 OCR 定制开发 的核心试金石。
工业与涉密场景的脱机困境:复杂退化文档字符提取的真实痛点
传统轻量级OCR引擎在设计之初,普遍基于水平方向文本检测框与单行高度固定的自回归循环神经网络(如CRNN或简单CTC模型)。这种假设在处理标准A4打印排版时表现尚可,然而一旦切入实际工业产线与历史做旧档案,算法便迅速失效:
金属铭牌或圆柱形药瓶表面的文字天然呈现为圆弧曲线排列,若强行采用水平矩形框进行外接截取,单个框内必然混合截入上下相邻的多行不相关字符,引发严重的文本串扰错乱;
强光直射在光滑覆膜纸张上形成的镜面反光斑点,会直接切断字符笔画之间的物理连接,使‘日’与‘口’、‘8’与‘3’等具有相似局部拓扑的字符在特征空间中发生混淆崩溃;
多语种混排环境下(如包含中文字形、阿拉伯连写体、拉丁字母与复杂特殊数理公式),传统的字符字典切分机制在遇到行尾非规则换行或生僻字时,往往导致批量丢字或输出连续的问号乱码。
任意多边形轮廓场与空间变换薄板样条重对齐算法
为了从根本上攻克几何非规则畸变,现代离线文档智能模型重构了基于任意多边形向量场的文本定位框架。网络在特征金字塔的深层空间输出每个文字实例的中心收缩骨架线、边界扩张方向场以及局部曲率张量。算法摆脱了对水平或轴对齐边界框的陈旧依赖,能够以连续多项式曲线或多边形控制点紧密贴合沿圆弧形、波浪形甚至环绕式分布的弯曲文本行。
紧随其后的是可微分的空间变换网络(Spatial Transformer Network)与薄板样条插值(TPS)算子。定位出的不规则多边形图像块无需经过低效的离散几何重投影,而是在隐空间流形内通过连续双线性重采样网格,被瞬时弹性拉伸展平为标准的矩形特征条带。这种基于特征流场的几何展平不仅抹平了纸张折叠引起的局部位移,更将由于相机倾斜拍摄带来的近大远小透视缩放完全消除,使得后续的文本识别解码器能够始终在最规整、最清晰的特征空间中展开字符推理。
针对局部严重光照反射造成的盲区伪影,解码网络前置了基于频域自编码器的高光修复补偿分支。该分支通过自适应分析字符笔画的高频连续性,在隐向量层面重构由于镜面反光而断裂的边缘轮廓,使被强光冲刷白化的细微笔画能够以数学先验平滑补齐,彻底杜绝了数字‘0’与字母‘O’、汉字‘土’与‘士’在高光区域的误判。
国产异构算力微架构下的计算图剪枝与算子汇编级熔合
在完全离线的嵌入式边缘计算硬件(如各类国产信创NPU、边缘计算盒子)上运行高阶几何对齐与多语种Transformer模型,面临着极其残酷的显存带宽与核心频率制约。许多模型在GPU服务器上耗时不到十毫秒,但移植到边缘硬件后却由于算子调度碎片化而暴跌至数百毫秒,无法满足工业流水线按件节拍要求。
算法研发团队深入到底层芯片的指令集与张量处理核心微架构,展开了全方位的编译级性能重构。针对频繁发生在内存总线上的张量重排(Reshape)、转置(Transpose)与层归一化(LayerNorm),工程人员重写了底层C++核函数,利用片上高速Scratchpad内存实现了跨层跨核的算子深度熔合(Operator Fusion)。多个连续的前向层被打包在单次硬件执行周期内跑通,消除了对片外DDR内存的高频来回读写。配合极具巧思的八位整数(INT8)动态非对称量化校准,模型存储体积被极限压缩至原先的四分之一,整套离线OCR流水线在信创单板计算机上的平均单页处理耗时被精准压减至四十五毫秒以内。
为应对工业边缘现场常见的长尾生僻字符与特殊行业符号(如特种压力容器认证标、化工管道流向箭头与危化品菱形危险品警示图例),模型构建了多任务解耦分类头。在主干特征输出层,网络同时分流出标准字符序列解码与非标象形图元掩码预测双通道,彻底解决了传统纯文本识别器在遇到非标图元时强制解码为乱码的技术缺陷。配合基于置信度自适应反馈的主动学习筛选机制,边缘设备能够在离线巡检间隙将疑似异常样本增量缓存至加密沙箱,为企业后续的领域模型版本迭代提供了高质量的真实工况语料回流管道。
跨语种混排折痕微小字符的工业高吞吐流水线实测
在针对某大型跨国重工装备企业进口零配件报关单据及保密技术图纸的离线翻拍识别测试中,该套深度优化的OCR系统展现出了坚韧的工业品格。测试集包含了数万张由于长途海运受潮而产生严重褶皱、局部油渍浸润以及夹杂着中、英、德、俄四国语言的手写与打字混排工程图纸。
在完全不接入外部互联网的物理隔离工作站上,系统以每分钟处理超过一千二百页的高吞吐速率连续稳定跑通全部数据。在极其细微的八号针式打印多联复写发票模糊字符测试中,全字符综合识别准确率维持在百分之九十九点二以上,生僻工程符号与多行紧密嵌套表格的栏目结构还原度达到百分之九十八点七。这一工程化实践确凿证实了高性能离线文档视觉分析在守护企业核心数据安全与驱动业务自动化中的坚实基石地位,需要实现复杂办公流程提效的机构可通过 图像识别定制开发 获得量身定制的算法方案。
更进一步的工程优化还体现在版面语义结构的端到端因果重构。通过将树状语法解析与视觉相对位置嵌入相结合,系统能够在输出识别字符的同时,自动生成带因果键值对(Key-Value Pair)与层级嵌套关系的JSON数据流,直接驱动下游ERP系统实现免人工复核的自动入库结算,构建了严密高效的数字化生产闭环。